从看懂,到亲手做出来
先猜结果,再运行代码,最后解释为什么。三个实验都能在 CPU 上完成。
第一次上机:先把环境跑通
一键下载三个实验完整包,解压后在含 labs 文件夹的目录打开终端。建议 Python 3.12。基础实验 A、B 不需要安装 PyTorch,也可按下面各实验入口单独下载。
python -m venv .venv
# Windows PowerShell,直接使用环境里的解释器,无需修改执行策略
.venv\Scripts\python -m pip install numpy scikit-learn matplotlib
.venv\Scripts\python labs/lab_a.py
.venv\Scripts\python labs/lab_b.py
# 实验 C 再安装 PyTorch
.venv\Scripts\python -m pip install torch
.venv\Scripts\python labs/lab_c.py
也可下载 Notebook,在 Jupyter 中选择安装了相同依赖的 Python 内核,从上到下运行。安装 Jupyter:python -m pip install notebook。查看输出图片时打开 outputs 文件夹;脚本的输出在 labs/outputs,Notebook 的输出在当前工作目录的 outputs。
遇到报错,先检查三件事
找不到模块:确认安装依赖与运行代码使用同一个解释器。找不到 common:把脚本和 common.py 放在同一目录。形状不匹配:先打印 X、y 和预测值的 shape,不要靠随意 reshape 隐藏问题。
实验 A:预测、比较与降维
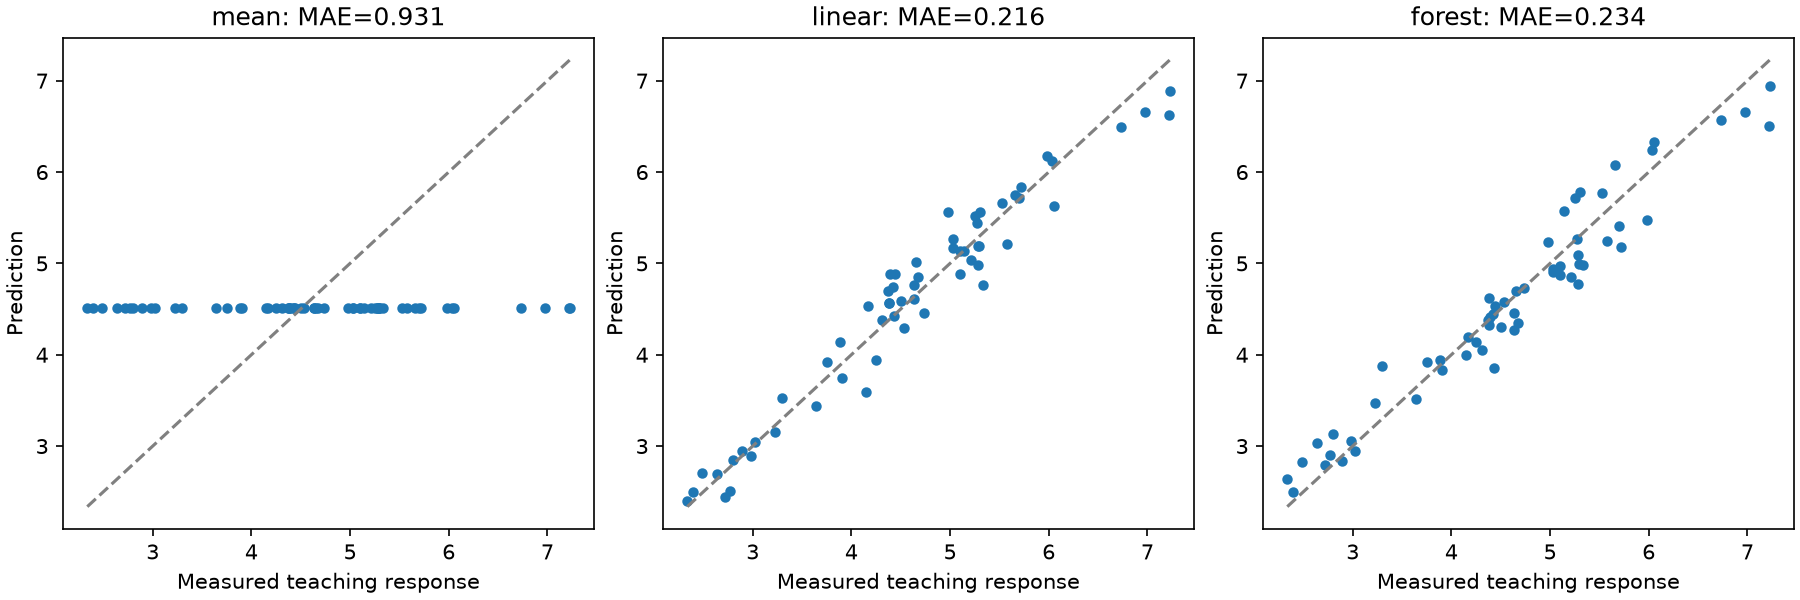
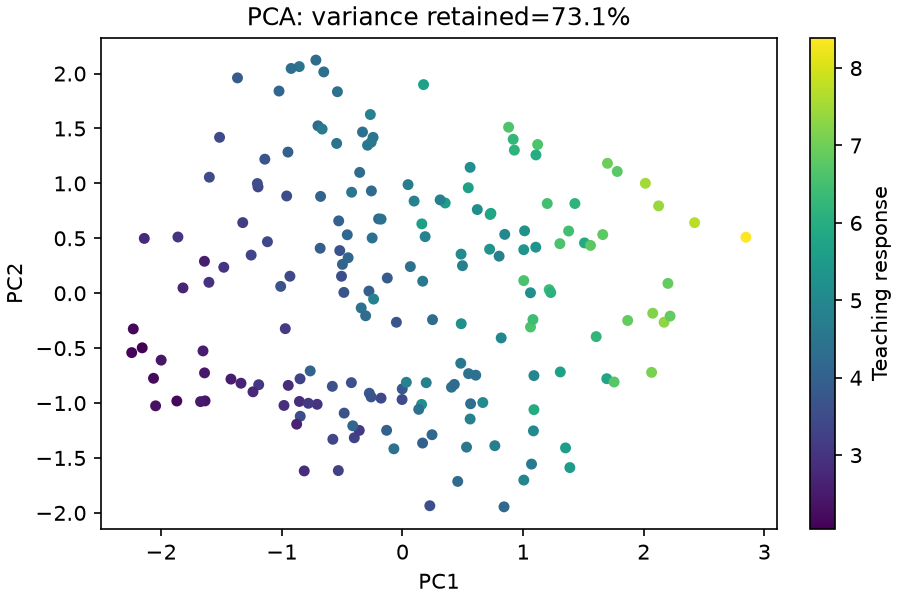
先猜:直线、森林和只猜平均值,谁会更好?运行后看 MAE 和预测图。观察点离对角线有多远,再解释误差。PCA 的颜色来自目标,仅用于观察,不参与降维拟合。
终端运行:python labs/lab_a.py。脚本需与 common.py 放在同一目录;Notebook 可独立运行。
阅读完整代码
"""实验 A:相同数据划分下比较基线、直线、森林,并观察 PCA。"""
import json
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.dummy import DummyRegressor
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_absolute_error
from sklearn.decomposition import PCA
from common import materials, OUT

X, y = materials()
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=.25, random_state=42)
print('训练/测试形状:', X_train.shape, X_test.shape)
cv = KFold(n_splits=5, shuffle=True, random_state=42)
forest = GridSearchCV(RandomForestRegressor(n_estimators=100, random_state=42),
                      {'max_depth': [3, 6, None]}, cv=cv, scoring='neg_mean_absolute_error')
models = {'mean': DummyRegressor(), 'linear': make_pipeline(StandardScaler(), LinearRegression()), 'forest': forest}
scores = {}
fig, axes = plt.subplots(1, 3, figsize=(12, 4), constrained_layout=True)
for ax, (name, model) in zip(axes, models.items()):
    model.fit(X_train, y_train)
    prediction = model.predict(X_test)
    scores[name] = float(mean_absolute_error(y_test, prediction))
    ax.scatter(y_test, prediction, s=16)
    lo, hi = min(y_test), max(y_test)
    ax.plot([lo, hi], [lo, hi], '--', color='gray')
    ax.set(xlabel='Measured teaching response', ylabel='Prediction', title=f'{name}: MAE={scores[name]:.3f}')
fig.savefig(OUT / 'a_predictions.png', dpi=150)
plt.close(fig)
# PCA 只在训练集拟合;颜色只是帮助观察,与 PCA 拟合无关。
projection = make_pipeline(StandardScaler(), PCA(n_components=2))
z = projection.fit_transform(X_train)
ratio = projection[-1].explained_variance_ratio_
fig, ax = plt.subplots(figsize=(6, 4), constrained_layout=True)
points = ax.scatter(z[:, 0], z[:, 1], c=y_train, s=18)
fig.colorbar(points, ax=ax, label='Teaching response')
ax.set(xlabel='PC1', ylabel='PC2', title=f'PCA: variance retained={sum(ratio):.1%}')
fig.savefig(OUT / 'a_pca.png', dpi=150)
plt.close(fig)
result = {'test_mae': scores, 'forest_best_parameters': forest.best_params_, 'pca_variance_ratio': ratio.tolist()}
(OUT / 'a_results.json').write_text(json.dumps(result, indent=2), encoding='utf-8')
print(json.dumps(result, indent=2))
实验 B:高分是否来自重复样品
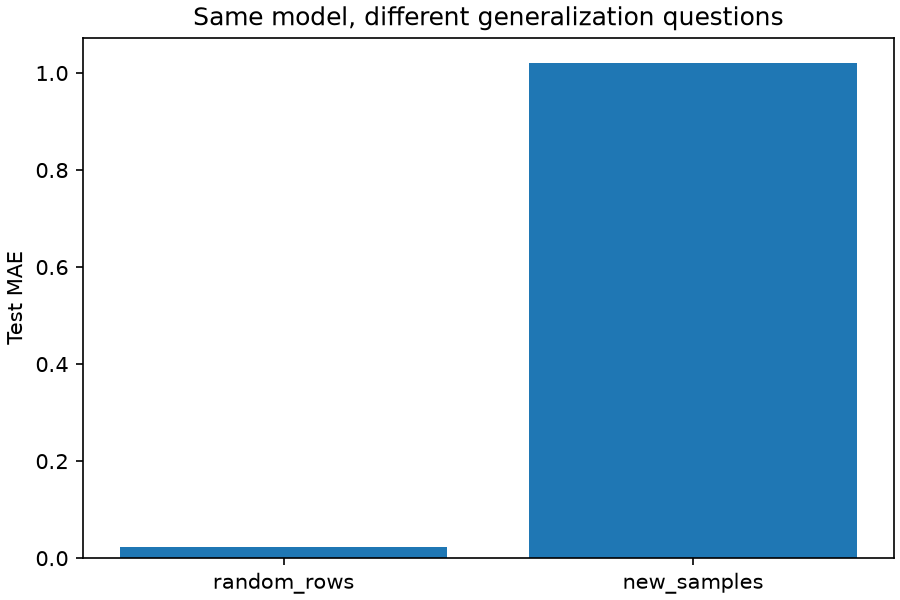
先猜:相同模型只改变划分方式,分数会不会改变?检查样品编号交集,再看误差。数据故意设计为可识别样品但不能预测新样品响应,帮助区分记忆与泛化。
终端运行:python labs/lab_b.py。脚本需与 common.py 放在同一目录;Notebook 可独立运行。
阅读完整代码
"""实验 B:随机按行划分与按新样品划分,回答的是不同问题。"""
import csv
import json
import numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split, GroupShuffleSplit
from sklearn.neighbors import KNeighborsRegressor
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.metrics import mean_absolute_error
from common import OUT

rng = np.random.default_rng(42)
# 每个样品具有一个可重复测得的“指纹”,响应在本例中是随机的,不能外推。
n_samples, repeats = 80, 8
fingerprints = rng.normal(size=(n_samples, 6))
responses = rng.normal(size=n_samples)
groups = np.repeat(np.arange(n_samples), repeats)
X = fingerprints[groups] + rng.normal(0, .005, (len(groups), 6))
y = responses[groups] + rng.normal(0, .02, len(groups))
with (OUT / 'simulated_repeats.csv').open('w', newline='', encoding='utf-8') as f:
    w = csv.writer(f)
    w.writerow(['sample_id'] + [f'fingerprint_{i}' for i in range(6)] + ['teaching_response'])
    w.writerows(np.column_stack([groups, X, y]))
row_train, row_test = train_test_split(np.arange(len(y)), test_size=.25, random_state=42)
group_train, group_test = next(GroupShuffleSplit(n_splits=1, test_size=.25, random_state=42).split(X, y, groups))
results = {}
for name, train, test in [('random_rows', row_train, row_test), ('new_samples', group_train, group_test)]:
    model = make_pipeline(StandardScaler(), KNeighborsRegressor(n_neighbors=1))
    model.fit(X[train], y[train])
    overlap = len(set(groups[train]) & set(groups[test]))
    results[name] = {'mae': float(mean_absolute_error(y[test], model.predict(X[test]))), 'overlapping_samples': overlap}
assert results['new_samples']['overlapping_samples'] == 0
fig, ax = plt.subplots(figsize=(6, 4), constrained_layout=True)
ax.bar(list(results), [v['mae'] for v in results.values()])
ax.set(ylabel='Test MAE', title='Same model, different generalization questions')
fig.savefig(OUT / 'b_split_comparison.png', dpi=150)
plt.close(fig)
(OUT / 'b_results.json').write_text(json.dumps(results, indent=2), encoding='utf-8')
print(json.dumps(results, indent=2))
实验 C:完整训练一个小网络
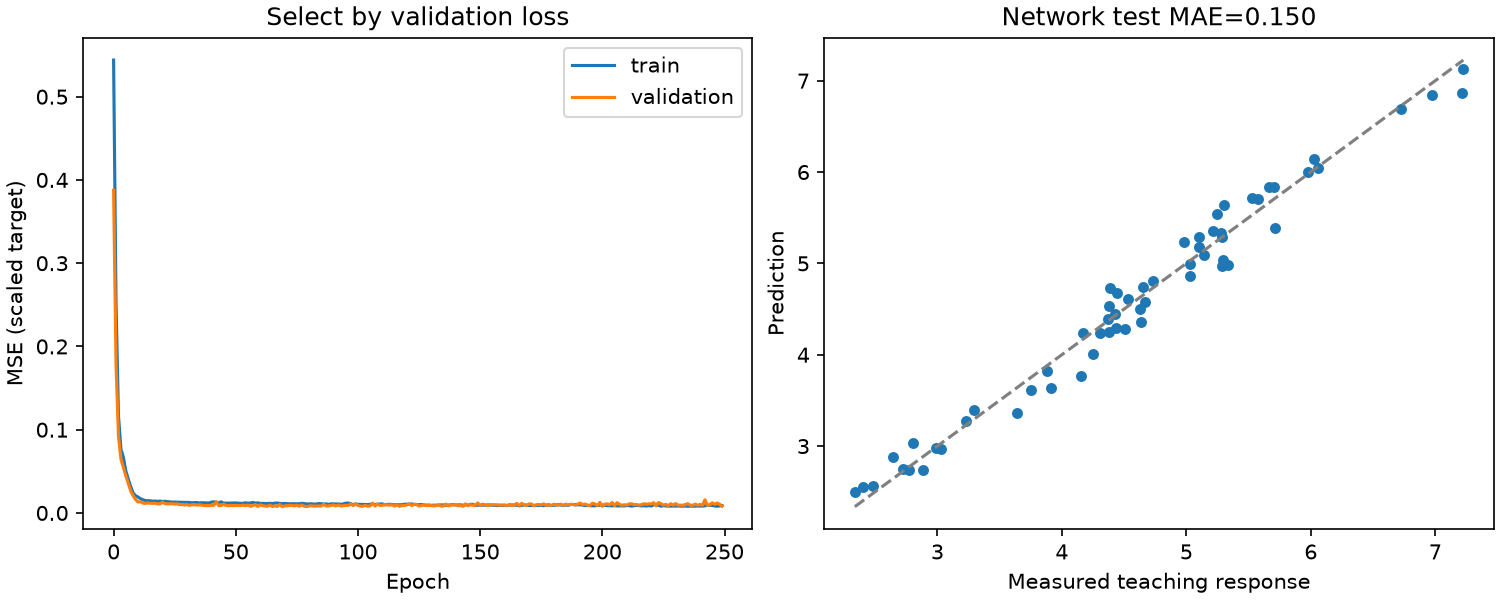
先猜:训练损失下降是否表示新数据上更准?观察验证曲线,选验证误差最低的参数,最后才计算测试 MAE。比较使用同一训练子集的均值、线性模型与网络。
终端运行:python labs/lab_c.py。脚本需与 common.py 放在同一目录;Notebook 可独立运行。
阅读完整代码
"""实验 C:CPU 上完整训练、验证选模、独立测试与参数恢复。"""
import copy
import json
import numpy as np
import torch
from torch import nn
from torch.utils.data import TensorDataset, DataLoader
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error
from common import materials, OUT

torch.manual_seed(42)
torch.set_num_threads(1)
X, y = materials()
# 与实验 A 相同的最终测试集;只在余下数据里建立验证集。
Xa, Xt, ya, yt = train_test_split(X, y, test_size=.25, random_state=42)
Xr, Xv, yr, yv = train_test_split(Xa, ya, test_size=.2, random_state=42)
sx, sy = StandardScaler().fit(Xr), StandardScaler().fit(yr.reshape(-1, 1))
def features(a):
    return torch.tensor(sx.transform(a), dtype=torch.float32)
def targets(a):
    return torch.tensor(sy.transform(a.reshape(-1, 1)), dtype=torch.float32)
xr, xv, xt = map(features, (Xr, Xv, Xt))
tr, tv = map(targets, (yr, yv))
assert tr.shape == (len(yr), 1)
loader = DataLoader(TensorDataset(xr, tr), batch_size=32, shuffle=True)
model = nn.Sequential(nn.Linear(3, 24), nn.ReLU(), nn.Linear(24, 1))
criterion = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=.01)
best, checkpoint, history = float('inf'), None, []
for epoch in range(250):
    model.train()
    total = 0.
    for xb, yb in loader:
        optimizer.zero_grad()
        loss = criterion(model(xb), yb)
        loss.backward()
        optimizer.step()
        total += loss.item() * len(xb)
    model.eval()
    with torch.no_grad():
        validation = criterion(model(xv), tv).item()
    history.append([total / len(xr), validation])
    if validation < best:
        best, checkpoint = validation, copy.deepcopy(model.state_dict())
model.load_state_dict(checkpoint)
model.eval()
with torch.no_grad():
    predicted = sy.inverse_transform(model(xt).numpy()).ravel()
# 同时给出同一训练子集上的线性模型及均值基线。
baseline = np.full(len(yt), yr.mean())
linear = LinearRegression().fit(sx.transform(Xr), yr).predict(sx.transform(Xt))
results = {name: float(mean_absolute_error(yt, p)) for name, p in [('mean', baseline), ('linear', linear), ('network', predicted)]}
torch.save(model.state_dict(), OUT / 'c_weights.pth')
restored = nn.Sequential(nn.Linear(3, 24), nn.ReLU(), nn.Linear(24, 1))
restored.load_state_dict(torch.load(OUT / 'c_weights.pth', weights_only=True, map_location='cpu'))
restored.eval()
with torch.no_grad():
    assert torch.allclose(model(xt), restored(xt))
# 预测还需配套缩放参数,不能只保存网络权重。
np.savez(OUT / 'c_scalers.npz', x_mean=sx.mean_, x_scale=sx.scale_, y_mean=sy.mean_, y_scale=sy.scale_)
fig, axes = plt.subplots(1, 2, figsize=(10, 4), constrained_layout=True)
axes[0].plot(history, label=['train', 'validation'])
axes[0].legend()
axes[0].set(xlabel='Epoch', ylabel='MSE (scaled target)', title='Select by validation loss')
axes[1].scatter(yt, predicted, s=18)
axes[1].plot([min(yt), max(yt)], [min(yt), max(yt)], '--', color='gray')
axes[1].set(xlabel='Measured teaching response', ylabel='Prediction', title=f'Network test MAE={results["network"]:.3f}')
fig.savefig(OUT / 'c_training.png', dpi=150)
plt.close(fig)
(OUT / 'c_results.json').write_text(json.dumps(results, indent=2), encoding='utf-8')
print('张量形状:', xr.shape, tr.shape)
print(json.dumps(results, indent=2))
运行后应该看到什么?
实验 A 输出三种模型的 MAE 和预测图。模拟关系含有非线性,但不预先规定哪个模型必须获胜;以结果解释模型偏差与数据量的关系。PCA 输出两维保留的方差比例,这不等于预测准确率。
实验 B 通常会出现随机按行划分误差较低、按新样品划分误差较高。关键证据是样品编号是否交叉。这个差距来自本实验的生成方式,不能当成所有数据的普遍数值规律。
实验 C 输出训练与验证损失曲线、预测图、三种方法的 MAE 和网络参数。恢复参数后会检查预测一致性;另保存缩放参数供新样品预处理。训练损失较低并不保证网络优于线性模型。
结课项目:让别人能检查你的结论
可选:模拟材料性质预测、重复测量泛化分析,或自己获得的有来源的专业数据。使用真实数据时记录来源、许可、单位、缺失值处理和适用范围。使用模拟数据时必须明确标注。
- 用一句话写问题:要预测谁、预测什么、预测时已知什么?
- 列出样本数量、输入列、目标与单位,检查重复样品和异常值。
- 先确定划分规则,再建立均值或多数类基线。
- 比较至少两种模型,所有调参只使用训练内部交叉验证或验证集。
- 最后在独立测试集评估,报告误差图、失败案例和适用范围。
- 提出独立实验或计算验证方案,提交可运行代码与环境版本。
建议评分:问题与数据说明 20%,划分与防泄漏 25%,基线和公平比较 20%,结果解释与局限 25%,复现材料 10%。模型分数高不自动得到高分;分析合理的负结果同样有价值。
建议课程考核:平时解释与小任务 20%,三个上机实验 40%,结课项目 40%。这是教学建议,可按实际学时调整。
十讲学习目标与任务
| 讲次 | 基础目标 | 提交任务 |
|---|---|---|
| 第 1 讲 | 分清样本、特征和标签;判断一个问题是回归还是分类;运行环境自检 | 选一个本专业问题,写出一行示例数据,并说明预测时哪些列已经知道。 |
| 第 2 讲 | 解释斜率和误差;画预测值与真实值图;比较模型与均值基线 | 完成实验 A:记录均值基线、线性回归和随机森林的测试 MAE;解释哪种更好以及好多少。 |
| 第 3 讲 | 区分类别与概率;手算精确率和召回率;解释阈值的影响 | 对课堂二分类示例分别用 0.3、0.5、0.7 阈值画混淆矩阵。阈值在验证集上选择,测试集只作最终评估。 |
| 第 4 讲 | 区分训练、验证、测试;用 Pipeline 做折内预处理;按预测目标选择划分方式 | 完成实验 B:记录两种划分的 MAE,检查样品编号交集,并写明你的研究要预测新测量还是新样品。 |
| 第 5 讲 | 读懂一棵浅树;比较单树与森林;区分预测重要性和物理因果 | 把树的最大深度设为 2、5、无限,比较训练误差与验证误差。最终测试只在选定设置后使用。 |
| 第 6 讲 | 说明缩放为何影响距离;比较不同 K;用一句话解释条件独立 | 在同一验证划分上比较 K=1、5、15,并比较缩放前后结果。只用训练数据拟合缩放器。 |
| 第 7 讲 | 区分聚类与分类;解释方差保留比例;谨慎解读二维图 | 完成实验 A 的 PCA 部分:保留两维,记录解释方差比例。改变缩放方式,说明图形为什么可能改变。 |
| 第 8 讲 | 说明非线性的作用;解释前向计算与反向传播;观察训练和验证曲线 | 先画出你预期的训练和验证曲线:欠拟合、合适、过拟合各一张。实验 C 跑完后,对照判断。 |
| 第 9 讲 | 运行完整训练循环;检查张量形状;比较基线与网络;保存并恢复参数 | 完成实验 C:提交训练/验证曲线、基线与网络的测试 MAE,并说明是否有证据值得使用网络。 |
| 第 10 讲 | 写清数据来源与适用范围;解释一个失败案例;提出独立验证方案 | 完成结课报告:问题、数据、划分、基线、模型比较、误差图、失败案例和下一步验证。明确区分模拟练习与真实研究。 |
后续阅读与代码依据
scikit-learn 逻辑回归文档 · PyTorch 参数保存与恢复
先读懂本课程的输入、输出和评估,再查工具文档中的参数说明。遇到版本差异时以所用版本的官方文档为准。